HotelSentinel: Widersprüche in Hotel-Listings sichtbar machen
Frühstück inklusive oder gegen Aufpreis? HotelSentinel vergleicht Hotelwebsite, Booking und Expedia. Ein Blick auf die Pipeline, nachvollziehbare Bewertungen und die Grenzen automatischer Audits.
- Agentic AI
- HotelSentinel
- AI Agent
- Python
- Playwright
- NestJS
- Angular
- Architektur
Engineering Journal · HotelSentinel · 2026
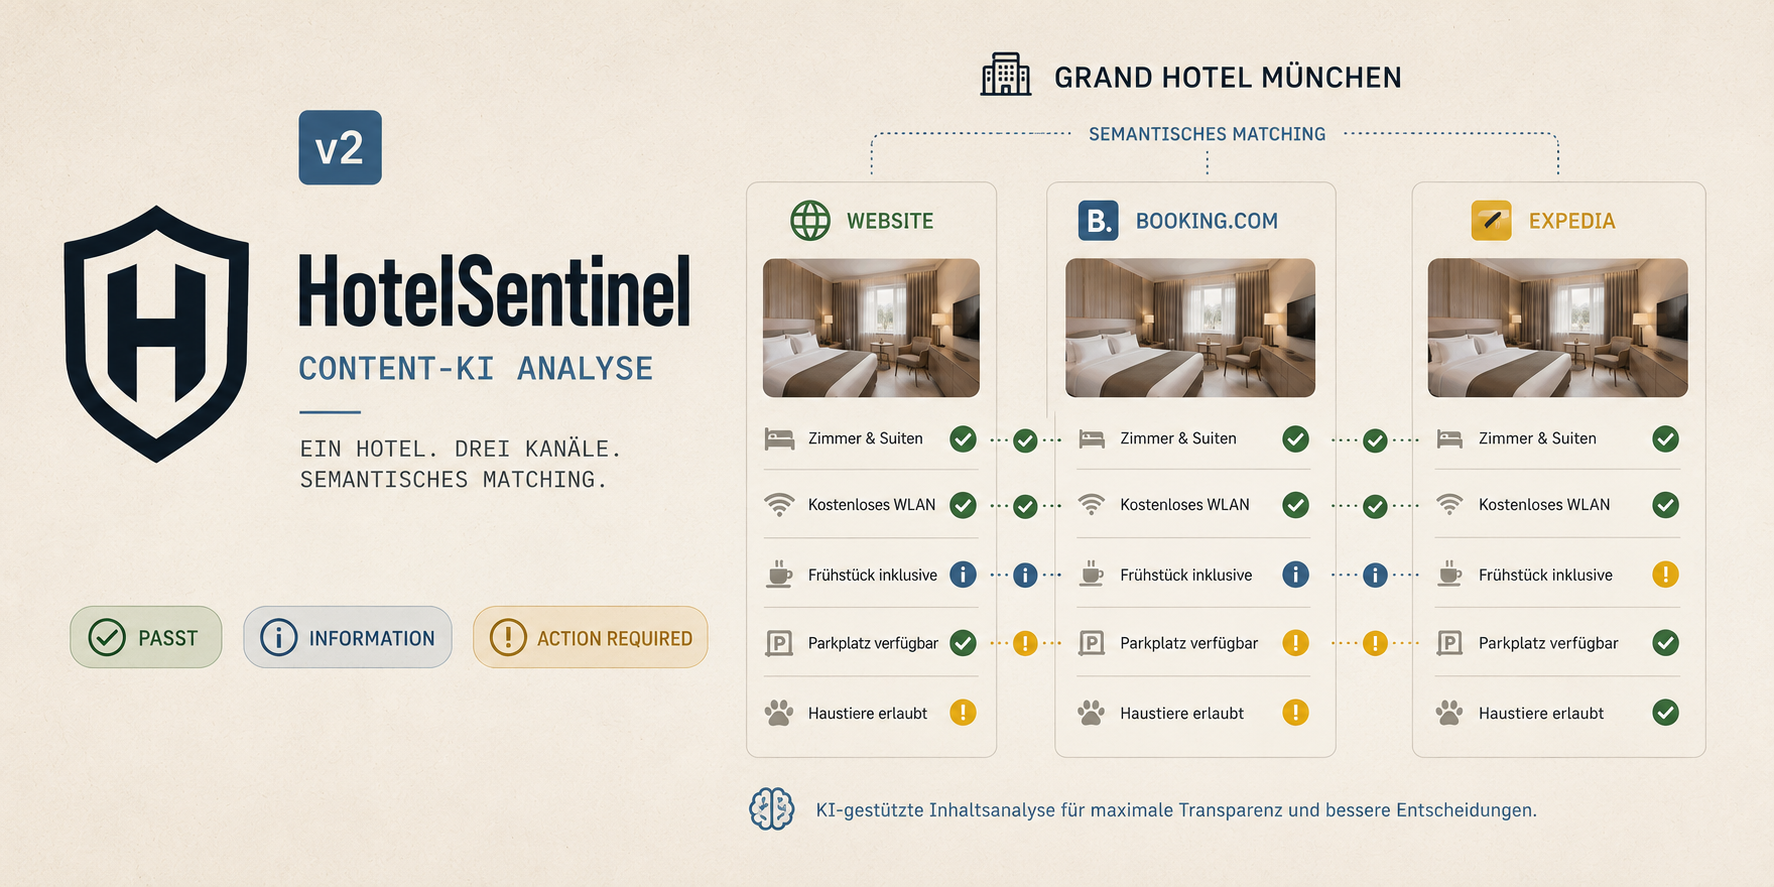
Auf der Hotelwebsite steht «Frühstück inklusive», auf einem Buchungsportal «gegen Aufpreis». Bezieht sich das auf dasselbe Zimmer und dieselbe Rate? Ist eine Angabe veraltet, oder vergleichen wir unterschiedliche Angebote? Dieses vereinfachte Beispiel zeigt, warum eine Liste von Unterschieden allein noch kein brauchbares Audit ist.
Mit HotelSentinel untersuche ich, wie sich die öffentlich sichtbare Darstellung eines Hotels über mehrere Kanäle vergleichen lässt. Dafür trenne ich das Sammeln der Inhalte, ihre strukturierte Extraktion und die regelbasierte Bewertung. Hier zeige ich den Aufbau, die Entscheidungen auf dem Weg von V1 zu V3 und die Grenzen dessen, was ein automatischer Bericht belegen kann.
Ein Hotel, mehrere Kanäle, unterschiedliche Erwartungen
Ein Hotel wird auf seiner eigenen Website und auf Buchungsportalen beschrieben. Zimmernamen, Ausstattungsangaben, Fotos und Beschreibungen werden dabei nicht zwingend gleichzeitig aktualisiert. Bei mehreren Hotels wächst der Aufwand, diese Darstellungen regelmässig nebeneinander zu prüfen.
Dabei muss nicht überall derselbe Text stehen. Ein Portal kann andere Bildformate verwenden oder Zimmernamen übersetzen. Interessant sind Unterschiede, die Gäste bei ihrer Entscheidung beeinflussen könnten: Ist eine Leistung enthalten? Gehört das gezeigte Foto zur passenden Zimmerkategorie? Fehlt auf einem Kanal eine wichtige Ausstattungsangabe?
Mein Ziel ist, solche Prüfstellen sichtbar und nachvollziehbar zu machen. Ein Bericht soll zeigen, welche Quellen voneinander abweichen und worauf dieser Befund beruht. Aus einer Abweichung allein lässt sich weder bestimmen, welcher Kanal korrekt ist, noch ein verlorener Umsatz berechnen. Der nächste Schritt bleibt die fachliche Klärung durch die verantwortliche Person.
Die Architektur: sammeln, strukturieren, vergleichen
HotelSentinel besteht aus drei Stufen mit klar getrennten Aufgaben. Gemeinsam bilden sie eine Pipeline; nicht jede Stufe braucht dafür ein autonom handelndes KI-Modell.
Collector → Extractor → Reviewer
HTML + Bilder → PlatformData → Bewertung + Bericht
- Collector: Lädt die Quellen – bei Buchungsportalen über einen Cloud-Browser, bei der Hotelwebsite über lokales Playwright. Bild-URLs werden regelbasiert gesammelt. Die Inhalte werden hier noch nicht fachlich bewertet.
- Extractor: AI Agent überführt das verschlankte HTML in strukturiertes JSON mit Hotelname, Beschreibung, Zimmern, Bewertung und Amenities. Ein Normalizer verarbeitet die Bilder und baut pro Kanal ein einheitliches
PlatformData-Objekt. - Reviewer: Vergleicht diese Objekte anhand von zwölf Kriterien. Die Bewertung läuft regelbasiert ohne weitere LLM-Abfrage und erzeugt Note, Befunde und Empfehlungen.
- Core: Enthält den gemeinsamen Datenvertrag, den Snapshot-Layer sowie Bild- und Textmetriken, darunter pHash für den Vergleich von Galeriebildern.
Rund um die Python-Engine orchestriert ein NestJS-Backend die Audit-Zyklen. Das Angular-Frontend zeigt das Portfolio und die Diff-Historie; Webhook-Alarme melden Verschlechterungen. Die Trennung hilft mir, einen auffälligen Befund seiner Ursache zuzuordnen: War die Quelle unvollständig, die Extraktion falsch oder die Bewertungsregel unpassend?
Snapshots machen die Bewertung wiederholbar
Live-Webseiten ändern sich. Auch eine LLM-Extraktion kann bei wiederholten Durchläufen variieren oder Informationen falsch zuordnen. Deshalb speichert HotelSentinel pro Hotel und Tag einen Snapshot: gesammeltes HTML, geladene Bilder und normalisierte Daten einschliesslich des Extraktionsergebnisses. Der AI Agent wird bei einer erneuten Bewertung dieses Snapshots nicht noch einmal aufgerufen.
Damit gilt die präzisere Regel: Gleicher Snapshot und gleiche Bewertungslogik mit gleichen Parametern ergeben dieselbe Note. Ändere ich einen Schwellwert, kann ich den gespeicherten Stand mit der neuen Regel bewerten, ohne die Webseiten erneut zu laden oder nochmals Extraktionskosten auszulösen. Eine veränderte Note zeigt dann eine Änderung der Bewertungslogik, nicht automatisch eine Änderung des Listings.
Der Fingerprint im Bericht hilft, den verwendeten Datenstand wiederzuerkennen. Er beweist aber nicht, dass die Extraktion fachlich richtig war: Ein Snapshot konserviert auch Fehler. Auffällige Ergebnisse müssen deshalb zur gespeicherten Quelle zurückverfolgt und geprüft werden können. Dass Sprachmodelle falsche oder nicht belegte Informationen erzeugen können, ist auch in der Dokumentation zur Verringerung von Halluzinationen beschrieben.
Zwölf Kriterien – und die Frage, was ein Unterschied bedeutet
Der Reviewer prüft zwölf Kriterien in drei Gruppen:
- Struktur und Naming: Zimmernamen, Hotelname und Anzahl der Kategorien.
- Fotos und Medien: Zimmerfotos, Galeriefotos, Fotoqualität, Qualitätsunterschiede zwischen Kanälen und geringe Fotoanzahl.
- Text und Bewertungen: Hotelbeschreibung, Zimmerbeschreibungen, Review-Scores und Amenities.
Die Negativpunkte führen zu einer Note von 1 (kritisch) bis 4 (sehr gut). Sie ist eine Zusammenfassung des regelbasierten Vergleichs. Für die Entscheidung sind die einzelnen Befunde und die verfügbare Datengrundlage wichtiger als die Note allein. Nicht erreichbare Portale müssen im Bericht sichtbar bleiben; fehlende Daten sind nicht mit einer nachgewiesenen fehlenden Ausstattung gleichzusetzen.
Das folgende vereinfachte Beispiel enthält keine gemessenen Projektergebnisse:
| Beobachtung | Was zu prüfen ist |
|---|---|
| «Frühstück inklusive» gegenüber «gegen Aufpreis» | Gleiche Zimmerkategorie, Rate und Reisedaten? Erst dann lässt sich ein möglicher Widerspruch beurteilen. |
| «Parkplätze vorhanden» gegenüber keiner Angabe | Eine Informationslücke; kein Beleg, dass es keine Parkplätze gibt. |
| «Deluxe Doppelzimmer» gegenüber «Deluxe Double Room» | Möglicherweise eine Übersetzung derselben Kategorie; kein Fehler allein wegen des Namens. |
Auch Bildähnlichkeit ist ein Hinweis, kein Beweis für die richtige Zimmerzuordnung. Perceptual Hashing beschreibt visuelle Ähnlichkeit; eine fachliche Zuordnung benötigt zusätzlichen Kontext. (ImageHash: Funktionsweise und Hash-Vergleich) Ein unterschiedlicher Review-Score ist ebenfalls für sich kein Nachweis einer falschen Darstellung.
Sechs Entscheidungen, die den Aufbau geprägt haben
1. Die KI bekommt eine begrenzte Aufgabe. Statt einer generierten Gesamteinschätzung lasse ich das Modell Informationen strukturieren. Die Regeln für die Bewertung bleiben separat. So kann ich die Extraktion und das Scoring unabhängig untersuchen.
2. V3 ersetzt viele portalspezifische Parser. In V2 verursachten eigene Selektoren pro Portal Wartungsaufwand bei Layoutänderungen. In V3 übernimmt der AI Agent die Extraktion aus verschlanktem HTML. Das reduziert diese Abhängigkeit, bringt aber einen anderen Prüfbedarf mit: Scheint das JSON plausibel, und ist jeder wichtige Wert in der Quelle belegt?
3. Einfrieren hilft beim Debuggen. Mit einem gespeicherten Stand kann ich einen Befund nachvollziehen und Regeln vergleichen, ohne gleichzeitig gegen eine inzwischen veränderte Webseite zu arbeiten. Reproduzierbarkeit und Richtigkeit bleiben dabei zwei verschiedene Anforderungen.
4. Die Vergleichsbedingungen gehören zum Audit. Sprache, Locale und Reisedaten beeinflussen die angezeigten Inhalte. Ein Belegungsfenster in der Zukunft kann andere Zimmer sichtbar machen, garantiert aber keine vollständige Liste. Wenn Seiten nicht zuverlässig geladen werden, braucht der Bericht eine erkennbare Datenlücke. Begrenzte Wiederholungen und Backoff sind Teil des Ladeprozesses.
5. «Nicht bewertbar» ist ein brauchbares Ergebnis. Wenn die Daten keine klare Aussage zulassen, hilft eine offene Prüfaufgabe mehr als ein unbelegter schlechter Befund. Das gilt auch für wirtschaftliche Aussagen: Aus dem Listing-Vergleich entsteht keine belastbare Umsatz- oder ROI-Schätzung.
6. Der Bericht muss eine nächste Handlung ermöglichen. Eine Note allein sagt wenig darüber, was das Hotelteam ändern sollte. Nützlich wird der Vergleich, wenn die verantwortliche Person Quellen nebeneinander prüfen, die Abweichung einordnen und eine Korrektur gezielt anstossen kann.
Projektsteckbrief
- Zielgruppe: Hotelgruppen und Portfolio-Manager
- Zeitraum: 2026
- Aufgabe: Öffentliche Hotel-Listings vergleichen und Prüfstellen dokumentieren
- Kanäle: Hotelwebsite, Booking, Expedia / Hotels.com
- Engine: Python, AI Agents für die Extraktion, Playwright, Cloud-Browser, pHash
- Plattform: NestJS, Angular, Qdrant
Der Beitrag beschreibt den Projektaufbau und meine Entscheidungen. Die Beispieltabelle dient der Erklärung; sie ist kein Kundenbericht und enthält keine erfundenen Messergebnisse.
Was ich gelernt habe – und was ich vertiefen möchte
Die Entwicklung von HotelSentinel hat mir ein praxisnahes Verständnis dafür vermittelt, wie AI Agents aufgebaut sind, welche Aufgaben sie übernehmen können und wo ihre Grenzen liegen. Besonders aufschlussreich war für mich das Zusammenspiel von Datenextraktion, klar definierten Aufgaben und regelbasierter Bewertung.
Diese Erfahrungen möchte ich gezielt vertiefen. Mich interessiert, wie sich Agenten-Workflows und die eingesetzten LLMs besser auf konkrete Aufgaben abstimmen lassen – etwa durch präzisere Prompts, geeignete Evaluationsverfahren und aufgabenspezifisches Fine-Tuning.
Mein Ziel ist, AI Agents zuverlässiger und effizienter einzusetzen und dabei Antwortqualität, Laufzeit und Ressourcenbedarf systematisch zu untersuchen. HotelSentinel ist für mich eine praktische Grundlage, um dieses Wissen weiter auszubauen.